SDD TableLite 后续
前情回顾
在 上篇文章 中,我解释了对当前常见的 SDD 流程(如 Spec Kit)的看法,认为它们可用性不高,主要有两点原因:
- 流程复杂,过程中输出大量文档,几乎无法 Review,失去了 Spec-Driven 的意义;
- 将需求拆散成一个个独立的 Spec,导致 Agent 没有项目的全局视野,无法做出正确的面向未来的决策;
然后我提出了一个适用于桌面软件开发的新流程:
- 创建一个 spec 目录,通过跟 Agent 对话生成文档,完成对整个软件所有需求的描述;
- 避免 Spec 内容中对实现细节的描述,只描述用户视角的需求,假设 Agent 有能力随时设计出实现细节;
- 不写代码,直接让 Agent 根据 Spec 生成 manual(用户手册)目录,要求 html 格式,Agent 需要脑补软件截图并通过 svg 画出来;
- 人工 Review 用户手册而不是 Spec,带有截图的手册更加容易 Review,要求 Agent 的所有改动保持 Spec 和 Manual 的同步;同时在 AGENTS.md 中要求 Agent 不可以自行修改 Spec/Manual,必须经过人工确认;
- Review 完成后,让 Agent 一次性读取所有 spec/manual 并自主完成所有开发;
这样,通过 Review 带截图的用户手册解决了上面提到的难以 Review 的问题。将所有 Spec 放在一个目录,让 Agent 一次性读取所有 Spec,解决了 Agent 没有全局视野的问题。
写上篇文章的时候,我刚刚开始实践,完成了 Spec 和 Manual 的生成,正在 Review。现在,我已经完成了 Review,并且让 Agent 完成了开发,继续跟大家分享一下经历。
项目在这里:TableLite。
Review 用户手册
Review 的过程还算顺利,也的确充分发挥了用户手册的优势,并且我要求的所有修改都是从截图上看出来的,很难想象如果只有文字描述,我还能不能发现这些问题。
总体来说,我大概提出了这些问题:
- 表数据查看界面需要能够选中一条数据后,在右侧纵向显示该条数据的所有字段和值,并且支持修改(这是我比较喜欢的 TablePlus 的功能);
- 简化标签栏的状态标记,只保留「有未提交修改」这一个状态;
- 简化查询编辑器,去掉字体大小切换功能;
- 简化导入导出,只需要支持 csv;
- 少量文档矛盾修复;
是的,Agent 的脑补能力还是很强的,帮我设计出了挺多「挺好」的功能,但我希望保持简单,毕竟自用软件,只保留我自己想要的就行;
由于「修改 Manual 的同时需要同步修改 Spec」这个要求已经在 AGENTS.md 中了,所以 Review 完成后,Spec 和 Manual 是同步的。
需求和 Manual 对齐了之后,我让 Agent 重读了所有的 Spec 和 Manual,寻找冲突。这一步还是不可避免地会发现一些冲突点,好在不多,几轮对话后就解决了。
Agent 自主开发
Review 完成后,就要真正进入开发了。不过我在此之前还是让 Agent 先判断了一遍:是否还有需要在技术方案层面提前确定的关键点。
Agent 又完整读了 Spec 和 Manual,向我确认了一些决策,我总共说了这么些话:
- user: 考虑一下当前项目想要开发测试完成,还需要哪些关键决策和基础设置
- user: docker-compose 是存在的
- user: 1. 保持简单 2. 你来定 3. 你来定 4. 硬编码中文,未来可以迭代 5. 你来定 6. 保持简单 7. 测试 make run,分发 make dist 8. 你来定
- user: 只支持 mysql 就行了
- user: 时区支持暂不考虑,原样维护 DB 中的值就行
完事后,我启动新的 Session,写了这段 prompt,开启了 Agent 的自主开发:
开始完整开发整个应用。
- 所有设计在 specs 和 manual 中已经完整说明,不需要再向我确认细节;
- 仔细考虑开发的步骤和验证的方式,确保最终交付是一个高质量且简单有效的实现;
- 充分利用 subagent,避免上下文爆炸,在当前这个主 session 中调度完成所有的任务;
- 在当前 dev 分支上按合理的任务拆分来提交代码;
Deepseek-Flash
上面的所有过程都是在用 Deepseek-Flash 完成的,毕竟它又快又便宜,这次的开发也用它。
任务开始于 23:36:28,结束于 00:58:03,耗时 1 小时 22 分钟。Agent 交付报告:
交付内容
从空壳一路实现到功能完整的应用,dev 分支共 11 个提交(Wave 0–7),132 个文件变更、约 3.2 万行。
Core(按 docs/tech-designs/ 的决策实现)
- Core/SQL:词法扫描、语句拆分、SQLValueLiteral、标识符引用、只读白名单、过滤器 SQL 生成 —— 全部纯函数
- Core/MySQL:MySQLSession actor(C shim 唯一入口、专用串行队列、多结果集、流式、KILL QUERY 取消、错误映射、保活、Console Log 回调)
- Core/Meta:information_schema 元数据 + TTL 缓存 + DDL 失效
- Core/Data:分页/排序/大字段两阶段加载的 SQL 生成与加载
- <省略>
我赶紧 build 试了一下,主体功能都是正常的,不过在一些 UI 交互细节上,的确没有能够做到和 Manual 的描述一致。
我再要求 Agent 做几轮自查、再人工纠正几次,问题应该都能解决。
但是,我突然想到,这不正是一个绝佳的试验场,来测试当下不同 LLM 的能力吗?我正好手上还有一个 Kimi 的订阅。
于是,我果断从 main 分支创建了新的 dev-kimi 分支,将 PI Agent 的模型切换为 Kimi,然后用完全一样的提示词开始了新一轮的开发。
Kimi K3
K3 明显强于 Deepseek-Flash,这一点我一直都知道,也有体会,很期待 K3 能做到什么程度。
虽然知道 K3 强,但平时我还是主要使用 Deepseek-Flash,除了 K3 用一会儿就到了 5 小时限额这个原因之外,主要还是因为相比之下 Deepseek-Flash 太快了。
K3 的任务开始于 07:19:05,然后我就去上班了,中间到达了 5 小时限制,直到我下班回来让他继续才最终完成。刨去中间停掉的时间,K3 总耗时约为 2 小时 40 分钟。完成后,Context 占用为 58.6%/262k,是的为了省钱,我用的是 K3-256K,我惊讶于 Agent 居然会这么省 Context。
虽然慢了很多,但 K3 的交付质量的确明显更高,除了没有明显 bug 之外,和 Manual 的一致性也是非常好(当然还是会有一些瑕疵需要后续调整)。
贴几张截图:
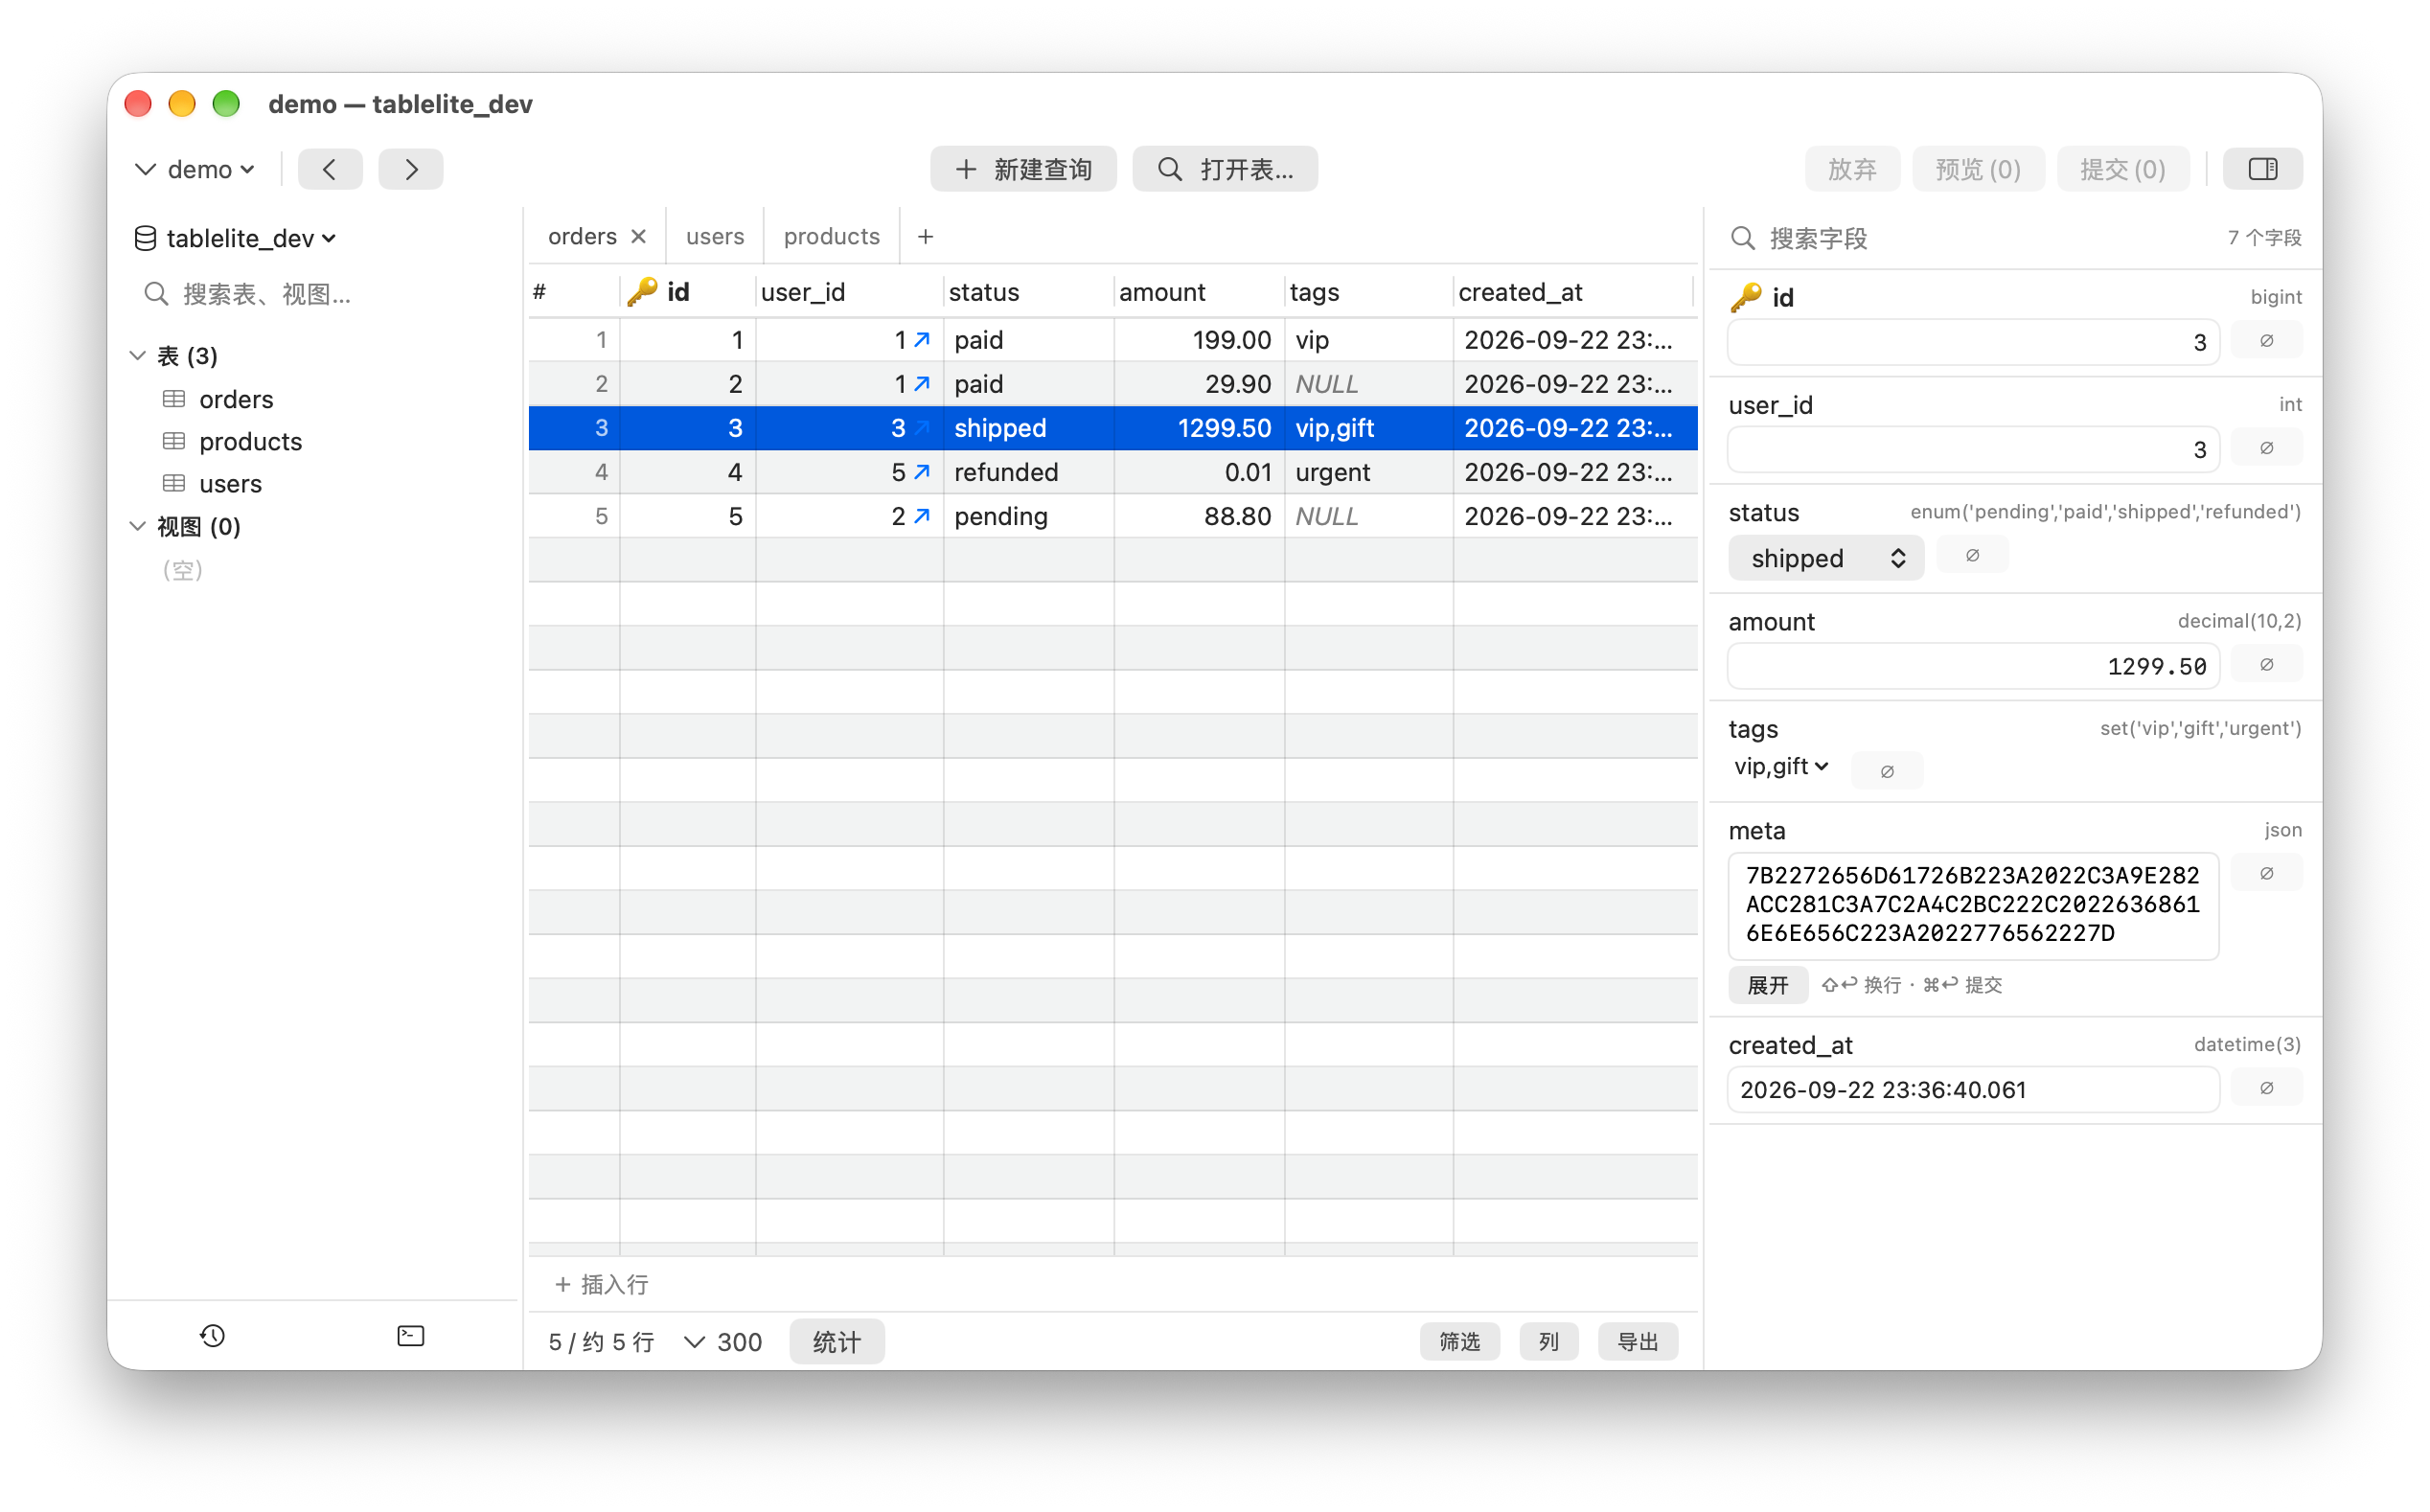
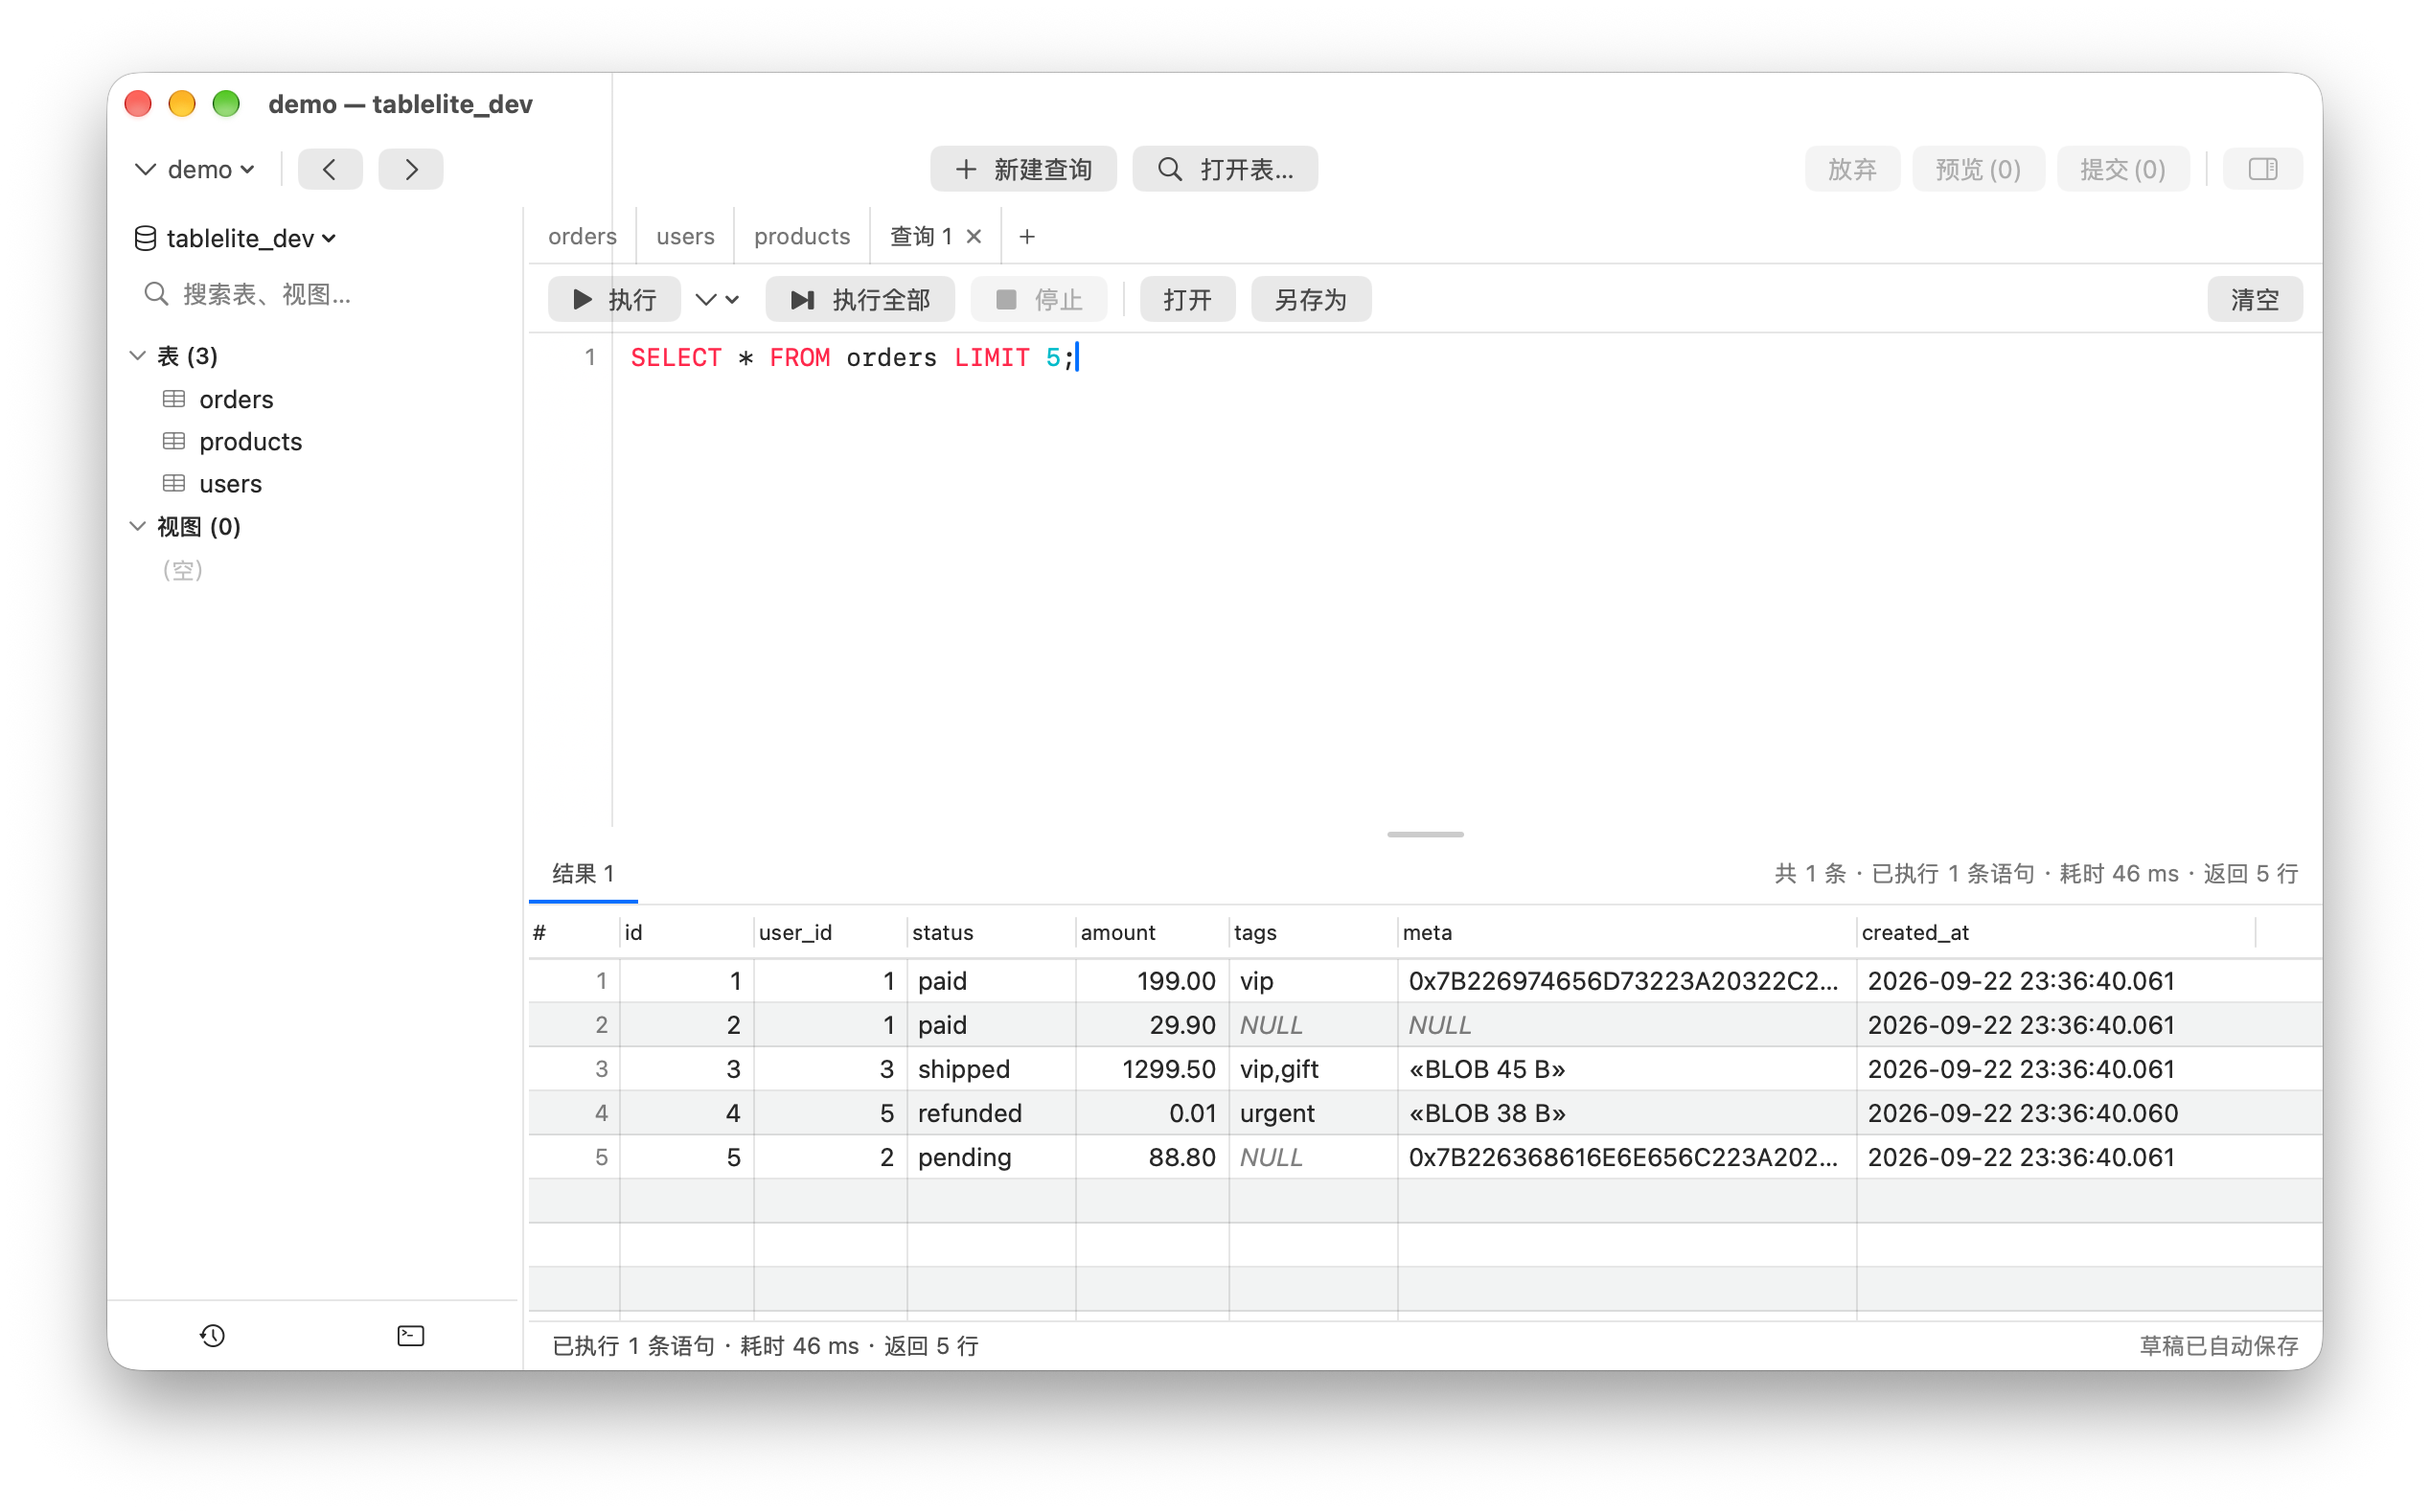
UI 上虽然没能做到完全一致,但其中有个主要原因是我一开始就要求 Agent 使用 macOS 原生开发,所以 Agent 会倾向直接使用原生组件,很难做到和 Manual 图一比一还原。
总结
这次尝试的整体结果我还是满意的,毕竟是 Agent 在我上班的时间完全自主完成了这个软件的开发,中间没有我的任何参与。
虽然 UI 上还是会有一些瑕疵,实际测试的时候还有一些性能问题需要优化,但都不涉及需求的变更,修起来也快。
我也思考了 UI 上一些不一致的原因,以及上下文控制的方法,并让 Agent 去分析了 K3 的开发会话,考虑在下一篇文章中详细说说,这一篇就到这里吧。